Errores de picking: causas, coste real y cómo eliminarlos
- Los errores de picking se reducen midiendo la tasa por línea, clasificando cada error por tipo y causa raíz y aplicando el control adecuado en el punto donde nace el error.
- En un estudio de la Universidad Politécnica de Wrocław publicado en Sensors en 2025, la tasa de error fue del 6,86 % con lista en papel, del 2,31 % con pick-to-light y del 1,18 % con un indicador de ubicación por puntero.
- La Universidad Técnica de Múnich midió una tasa media cercana al 0,3 % con lista en papel en su estudio sobre prevención de errores: una posición errónea de cada 300.
- La preparación de pedidos supone el 55 % de los costes de un almacén típico, según la Universidad Erasmus de Rotterdam.
- Una tasa por línea pequeña se multiplica con las líneas: con 5 líneas por pedido y un 0,3 % de error por línea, casi el 1,5 % de los pedidos sale con algún fallo.
Un error de picking cuesta mucho más que la línea mal servida. Detrás vienen la llamada del cliente, la recogida, la re-preparación, el reenvío, el abono y, a veces, la pérdida del cliente.
La buena noticia es que los errores de picking no son una fatalidad. Tienen causas concretas y repetibles: ubicaciones confusas, referencias parecidas juntas, unidades de medida mal definidas, prisa en los picos y procesos de confirmación débiles.
Aquí explicamos cómo medirlos, cómo calcular lo que cuestan, qué dice la investigación sobre cada método y qué medidas funcionan. Al final hay un ejemplo con supuestos y la fórmula a la vista.
Qué es un error de picking y cómo se mide
Un error de picking es cualquier diferencia entre lo que pide el pedido y lo que sale del almacén. El estudio de la Universidad Técnica de Múnich sobre prevención de errores en la preparación manual los agrupa en tres tipos básicos, que conviene usar como clasificación mínima:
- Error de tipo: un artículo equivocado sustituye al correcto o se añade a él.
- Error de cantidad: la referencia es la correcta, pero sobran o faltan unidades.
- Error de omisión: una línea se salta y no se prepara.
En la práctica añadimos el error de estado (dañado, caducado o lote equivocado) y el de destino (pedido correcto en la caja o el cliente equivocado).
La medida importa tanto como la clasificación. Hay que decidir si la tasa se calcula por línea, por unidad o por pedido, porque dan números muy distintos. La relación entre la tasa por línea e y la tasa por pedido con n líneas es:
P(pedido con error) = 1 − (1 − e)^n
Con e = 0,3 % y n = 5 líneas, sale un 1,49 % de pedidos con algún fallo. Con 20 líneas por pedido, sube al 5,8 %.
Una medición honesta separa los errores detectados internamente de los reclamados por el cliente y estima los no detectados con auditorías por muestreo. Los indicadores de preparación y cómo se calculan se explican en KPI picking: los indicadores que de verdad importan en la preparación de pedidos.
Cuánto cuesta un error de picking
El coste de un error tiene una parte directa y una parte que casi nadie suma. La directa incluye el tiempo de gestión de la incidencia, la recogida o devolución, la re-preparación, el segundo envío y la merma del producto que vuelve en mal estado. La oculta incluye stock descuadrado, recuentos extra y el riesgo de perder al cliente.
Para calcular la parte de mano de obra conviene usar el coste real de nómina y contrastarlo con la estadística pública. Según la Encuesta Trimestral de Coste Laboral del INE, en el cuarto trimestre de 2025 el coste por hora efectiva fue de 26,51 euros y el coste por trabajador en transporte y almacenamiento llegó a 3.633,98 euros al mes, un 6,2 % más que un año antes.
Además, la preparación es la actividad que más pesa en el almacén. La presentación de la Universidad Erasmus de Rotterdam sobre preparación de pedidos cifra en el 55 % la parte de los costes de un almacén típico que corresponde al picking.
Y el volumen de pedidos pequeños sigue creciendo. Según Eurostat, el 77 % de los usuarios de internet de la UE compró o encargó bienes o servicios en línea en 2024, frente al 59 % de 2014. Más pedidos pequeños significan más ocasiones de error y un cliente final que reclama directamente.
Las causas raíz: personas, método y entorno
El estudio de Múnich agrupa las causas en cuatro bloques: personas, método, entorno y otras. Señala dos mecanismos frecuentes: la falta de atención, que lleva a contar o estimar mal, y la presión de tiempo, que la amplifica. También identifica la confirmación de un paso antes de haberlo completado como fuente habitual de errores.
En las auditorías que hacemos, las causas concretas se repiten:
- Ubicaciones parecidas o mal etiquetadas, con etiquetas a la altura equivocada o deterioradas.
- Referencias similares en ubicaciones contiguas: tallas, colores, gramajes o versiones de un mismo producto.
- Unidades de medida confusas: unidad, caja interior y caja máster sin diferenciar.
- Stock mal ubicado tras la reposición, que convierte un picking correcto en un error.
- Picos con personal nuevo sin periodo de adaptación.
- Confirmación por tecla o por lectura de la ubicación sin lectura del producto.
- Fatiga y mala ergonomía. La encuesta ESENER 2024 de EU-OSHA recoge movimientos repetitivos de mano o brazo en el 63 % de los centros de trabajo europeos y levantamiento o movimiento de cargas pesadas en el 52 %.
La regla es analizar cada error con su causa raíz, no con su culpable. Si la investigación termina en el preparador, el error volverá con el siguiente.
Qué dice la investigación sobre cada método de preparación
Los datos de laboratorio no se trasladan tal cual a un almacén real, pero ordenan las alternativas. El estudio comparativo de la Universidad Politécnica de Wrocław publicado en Sensors en 2025 probó tres sistemas con participantes sin experiencia previa: 71 personas con pick-to-light y con un sistema que señala la ubicación con un puntero de luz, y 28 con lista en papel. La tasa de error fue del 6,86 % con papel, del 2,31 % con pick-to-light y del 1,18 % con el indicador por puntero. Un preparador con nueve años de experiencia no cometió ningún error: el método importa mucho con personal nuevo.
El estudio de Múnich midió en su laboratorio una tasa media cercana al 0,3 % con lista en papel. La diferencia con Wrocław muestra lo sensible que es la cifra al ensayo: hay que medir en la propia operación.
Sobre el picking por voz, el análisis de Fontin y Lin en Applied Sciences (2020) recoge un estudio previo según el cual la voz es significativamente más productiva que el terminal de radiofrecuencia y produce de media un 21,4 % menos errores. En la presentación de Erasmus, voz y terminal dieron sustancialmente menos errores, y pick-to-light fue el más productivo en modo zona.
| Método o control | Qué error ataca mejor | Punto débil | Cuándo encaja |
|---|---|---|---|
| Terminal con escaneo de producto | Tipo y lote | Más lento si se escanea cada unidad | Muchas referencias parecidas o trazabilidad por lote |
| Picking por voz | Omisión y tipo, con dígito de control | La cantidad sigue dependiendo del conteo | Manos libres, frío, productos pesados |
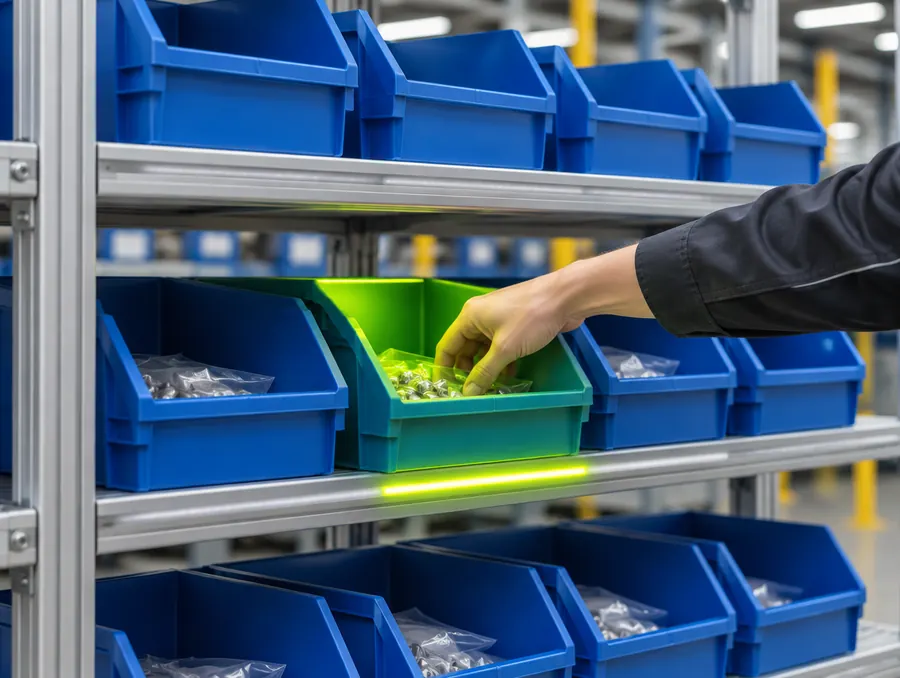
| Pick-to-light | Tipo y omisión en zonas de alta rotación | Coste por ubicación; errores por prisa | Pocas referencias muy activas y muchas líneas |
| Control de peso al cierre | Cantidad y omisión | No distingue artículos de igual peso | Pesos unitarios estables y diferenciados |
| Visión artificial en embalaje | Tipo, cantidad y estado | Requiere imágenes de referencia y buena iluminación | Volumen alto y producto visualmente distinguible |
El funcionamiento de las luces en ubicación se explica en Qué es el pick to light, cómo funciona y cuándo compensa en la preparación de pedidos.
Medidas de proceso que reducen errores sin comprar equipos
Antes de invertir conviene agotar las medidas de proceso: son baratas y, sin ellas, la tecnología rinde menos.
- Separar referencias parecidas: no colocar juntas tallas, colores o versiones de un mismo producto.
- Revisar la asignación de ubicaciones con datos de rotación y de parecido entre referencias. Cómo hacerlo se trata en Slotting almacén: cómo ubicar cada referencia por rotación, COI y afinidad para caminar menos.
- Definir la unidad de medida de forma inequívoca en el sistema, en la pantalla o en la voz y en la etiqueta de la ubicación.
- Exigir la lectura del producto, no solo de la ubicación, en las referencias con más historial de errores.
- Separar el error de reposición del error de preparación: si el stock está en la ubicación equivocada, el preparador no tiene culpa y la corrección es otra.
- Revisar una muestra de pedidos del personal nuevo en sus primeras semanas.
Y sobre todo, un registro de errores útil: fecha, pedido, referencia, ubicación, tipo de error, quién lo detecta y causa raíz. Con tres meses de registro suele aparecer que un número reducido de referencias y ubicaciones concentra buena parte de los fallos.
¿Cuánto te cuestan al año tus errores de picking?
Con tu registro de errores, tus pedidos y tus costes calculamos lo que te cuesta cada fallo y qué medida de proceso o de control te da más retorno, con los supuestos escritos.
Pide un estudio de tu preparaciónMedidas técnicas: dónde poner cada control
La tecnología se elige por el tipo de error que domina y por el punto donde se detecta mejor. Hay dos estrategias combinables.
Prevenir en el origen: guiar al preparador para que coja lo correcto a la primera. Aquí entran la lectura del producto, la voz con dígito de control, las luces y la mercancía a persona, donde la ubicación de origen llega sola.
Detectar antes de cerrar: comprobar el pedido antes de que salga. Aquí entran el control de peso al cierre, el escaneo en el puesto de embalaje y la visión artificial. El control de peso detecta faltas y excesos cuando la diferencia de peso es suficiente frente a la tolerancia del producto y del embalaje, pero no detecta el cambio entre artículos de peso similar. La visión complementa ese hueco; sus aplicaciones se tratan en Visión artificial logística: control de calidad con reglas o deep learning y cómo validarlo.
El WMS debe enviar la información a cada dispositivo, recoger las confirmaciones y bloquear el pedido si no supera el control. Un control que solo avisa y no bloquea acaba ignorándose en los picos.
Error habitual: comprar un sistema para toda la nave cuando el problema está concentrado en una familia de productos.
Ejemplo con supuestos: cuánto cuestan tus errores de picking
Ejemplo con supuestos. Todas las cifras de volumen, coste por error, inversión y mejora son hipotéticas y sirven solo para ilustrar el cálculo; no son datos de un cliente ni precios de mercado.
Supuestos:
- 1.200 pedidos al día, 5 líneas por pedido y 250 días de trabajo al año.
- Tasa de error actual por línea: e₀ = 0,3 %, del orden de la medida por Múnich con lista en papel.
- Coste por pedido con error: 0,15 h de gestión y 0,10 h de re-preparación al coste por hora efectiva del INE de 26,51 €, más 7 € de reenvío, 6 € de recogida y 3 € de merma media supuestos.
- Mejora supuesta tras un control de lectura de producto y peso al cierre: e₁ = 0,1 % por línea.
- Inversión supuesta: 120.000 €. Coste recurrente supuesto: 8.000 € al año.
Paso 1. Pedidos al año = 1.200 × 250 = 300.000. Tasa de pedidos con error actual = 1 − (1 − 0,003)^5 = 1,491 %. Pedidos con error = 300.000 × 1,491 % ≈ 4.473 al año.
Paso 2. Coste por pedido con error = 0,25 × 26,51 + 7 + 6 + 3 = 6,63 + 16 = 22,63 €.
Paso 3. Coste anual actual = 4.473 × 22,63 ≈ 101.200 €.
Paso 4. Con la mejora: 1 − (1 − 0,001)^5 = 0,499 %. Pedidos con error ≈ 1.497 al año. Coste anual ≈ 1.497 × 22,63 ≈ 33.900 €.
Paso 5. Ahorro bruto ≈ 101.200 − 33.900 = 67.300 € al año. Flujo neto = 67.300 − 8.000 = 59.300 €.
Paso 6. Plazo de retorno = 120.000 ÷ 59.300 ≈ 2,0 años.
No se ha contado el cliente perdido ni los recuentos de inventario, que mejorarían el retorno. Al revés, si el coste real por error fuera la mitad, el plazo se alargaría bastante. El dato más sensible es el coste por pedido con error, y es el que más merece la pena medir. El método completo para el retorno de una inversión está en ROI de un almacén automático: cómo calcularlo paso a paso.
Si quieres hacer este cálculo con tus pedidos reales, pide tu estudio gratuito y lo revisamos contigo.
Checklist: qué medir y qué preguntar al proveedor antes de decidir
Qué medir en tu operación:
- Tasa de error por línea y por pedido, separando errores detectados internamente y errores reclamados por el cliente.
- Reparto por tipo: tipo, cantidad, omisión, estado y destino.
- Concentración: qué referencias, ubicaciones, turnos y familias acumulan más errores.
- Coste real por pedido con error, con todas sus partidas.
- Líneas por pedido, unidades por línea y peso unitario por referencia.
Qué preguntar al proveedor:
- Qué tipos de error detecta su solución y cuáles no, por escrito.
- Si el control bloquea el pedido o solo avisa, y quién puede saltárselo.
- Cómo se integra con tu WMS o ERP, qué mensajes intercambia y quién mantiene esa integración.
- Qué ocurre con el rendimiento por hora: cuánto tiempo añade el control a cada línea o a cada pedido.
- Cómo se mide la tasa de error en la prueba de aceptación y con qué muestra.
- Qué mantenimiento, repuestos y soporte incluye la oferta.
Cómo lo resolvemos en Shuttlia
Nuestro método parte de los errores reales y no del catálogo:
- Toma de datos de la operación: registro de errores, pedidos, líneas, referencias, ubicaciones, turnos y costes, con visita a la nave.
- Análisis de causa raíz, para separar lo que se arregla con proceso de lo que necesita tecnología.
- Layout y simulación: diseñamos alternativas de método, ubicación y control, y las simulamos con tu histórico para ver su efecto en errores y en líneas por hora.
- Propuesta cerrada con rango de inversión, con el cálculo del coste de los errores y el retorno con supuestos escritos.
- Integración con tu ERP o WMS, para que el control bloquee de verdad, y servicio posventa con mantenimiento y soporte.
Si la conclusión es que basta con cambiar el proceso, también te lo decimos. Para saber cuánto te cuestan hoy los errores y cuál es la medida con más retorno, pide tu estudio gratuito y lo vemos con tus datos.
Conclusión
Los errores de picking no se eliminan con una consigna de tener más cuidado. Se eliminan midiendo la tasa por línea y por pedido, clasificando cada error por tipo y por causa, y poniendo el control adecuado donde nace el error o justo antes de que el pedido salga.
El método de preparación cambia mucho la tasa de error, sobre todo con personal nuevo, y ninguna tecnología cubre todos los tipos. El ejemplo muestra que el coste de los errores puede justificar una inversión razonable, siempre que el coste por error esté bien medido.
¿Lo aplicamos a tu almacén?
Cuéntanos tus palés, referencias y picos. Te devolvemos sin coste el cuello de botella, la solución que encaja y un rango de inversión.
Pide tu estudio gratuitoPreguntas frecuentes
¿Qué tasa de errores de picking es razonable?
Depende del sector, del tamaño del pedido y del método de preparación, así que no hay una cifra universal. Lo importante es medirla por línea y por pedido con el mismo criterio cada mes. Recuerda que una tasa por línea baja puede dar una tasa por pedido alta si los pedidos tienen muchas líneas.
¿El control de peso detecta todos los errores?
No. Detecta faltas y excesos cuando la diferencia de peso supera la tolerancia del producto y del embalaje. No detecta el cambio entre artículos de peso similar, como dos tallas o dos colores de una misma prenda. Por eso suele combinarse con lectura del producto o visión artificial.
¿Es mejor el pick-to-light o el picking por voz?
Depende del tipo de error y de la operación. Las luces encajan con pocas referencias muy activas y muchas líneas; la voz, cuando se necesitan las manos libres o el entorno es frío. En los estudios citados ambos reducen errores frente al papel, pero ninguno elimina los errores de cantidad si el preparador cuenta mal.
¿Cómo se calcula el coste de un error de picking?
Se suman el tiempo de gestión de la incidencia, la recogida o devolución, la re-preparación, el segundo envío y la merma, todo con costes reales de la empresa. El tiempo se valora con el coste por hora de nómina cargado. Lo que es difícil de medir, como el cliente perdido, se muestra aparte para no inflar el cálculo.
¿Sirve de algo automatizar si el problema es el slotting?
Sí, pero rinde menos. Si referencias parecidas están juntas o la reposición deja stock en la ubicación equivocada, cualquier tecnología trabajará contra el proceso. Lo eficaz es corregir primero la asignación de ubicaciones y la reposición y después elegir el control.
¿Cuánto tarda en notarse una mejora?
Las medidas de proceso, como separar referencias parecidas o definir bien las unidades de medida, se notan en semanas si se mide bien. Las técnicas dependen de la integración y de la curva de aprendizaje del personal. En el estudio de Wrocław, el tiempo con el indicador por puntero se estabilizó hacia la cuarta pasada.
Fuentes
- Łopuszyński, Janusz y Karwat (Universidad Politécnica de Wrocław) - Comparative Study of Selected Order-Picking Methods, Sensors 25(3), 923, 2025
- Rammelmeier, Galka y Günthner (Universidad Técnica de Múnich) - Fehlervermeidung in der Kommissionierung, Logistics Journal Proceedings, 2012
- R. de Koster, Universidad Erasmus de Rotterdam - Orderverzamelen: mens of machine, Material Handling Forum, 2013
- Fontin y Lin - A Joint Comparative Analysis of Routing Heuristics and Paperless Picking Technologies, Applied Sciences 10(24), 8777, 2020
- INE - Encuesta Trimestral de Coste Laboral, cuarto trimestre de 2025
- Eurostat - E-commerce: 77% of internet users bought online in 2024
- EU-OSHA - Resultados de la encuesta ESENER 2024 (nota de prensa)